英伟达NVIDIA Tesla T4 16G 参数与推理场景,与 A10、A2 怎么选?
 道通存储
概述:NVIDIA T4 是数据中心里服役时间最长的一批推理卡之一:单槽、无外接供电、70W 功耗,几乎所有 1U 服务器都能塞进去。它算力不算高,但胜在能效与部署成本,至今仍是中小规模企业推理与视频转码的...
NVIDIA T4 是数据中心里服役时间最长的一批推理卡之一:单槽、无外接供电、70W 功耗,几乎所有 1U 服务器都能塞进去。它算力不算高,但胜在能效与部署成本,至今仍是中小规模企业推理与视频转码的主力选择。
一、参数与形态
T4 基于图灵架构,16GB GDDR6 显存,显存带宽约 320GB/s, PCIe Gen3 x16 接口,单槽半高(low profile)形态,整卡功耗 70W,不需要外接供电。计算面:单精度约 8.1 TFLOPS,FP16 约 65 TFLOPS,INT8 约 130 TOPS,INT4 约 260 TOPS,内置 320 个图灵张量核心。
项目 | 规格 |
架构 | NVIDIA Turing |
显存 | 16GB GDDR6 |
显存带宽 | 约 320 GB/s |
算力 | FP32 约 8.1 TFLOPS;INT8 约 130 TOPS;INT4 约 260 TOPS |
功耗 / 形态 | 70W;单槽半高,无外接供电 |
接口 | PCIe Gen3 x16 |
▲T4 关键规格(具体以厂商公开规格为准)
二、推理场景里它的真实位置
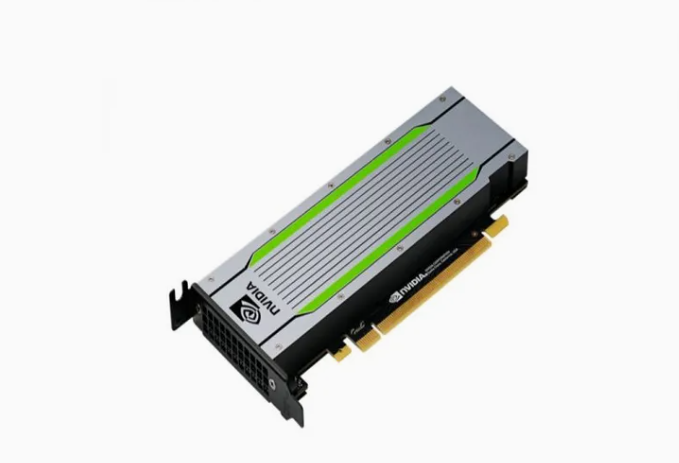
T4 的甜点区在“中等并发、量化推理、视频编解码”。INT8/INT4 量化之后,参数量在十亿级别的模型可以流畅跑在单卡上;一机插 4 张 T4,能撑起一个中等规模的推理服务。视频侧它带有独立的编解码单元,做转码、结构化分析的性价比很高。
不适合的场景也很明确:大模型全参数推理、需要大显存长上下文的场景、需要 FP8/FP16 高吞吐的训练与微调。这些需求拿 T4 顶,显存和算力都会先撞墙。
三、与 A10、A2 怎么选
型号 | 显存 | 架构 | 功耗 | 适用判断 |
Tesla T4 | 16GB GDDR6 | Turing | 70W | 部署密度优先、视频与轻量推理 |
A10 | 24GB GDDR6 | Ampere | 150W | 显存更大、算力更强,中等规模推理与图形 |
A2 | 16GB GDDR6 | Ampere | 40W 至 60W 区间 | 低功耗边缘推理、密度极高 |
▲三款推理卡的对比
选型口径:预算紧、机箱空间紧、模型已经量化过,选 T4;显存吃紧、需要更强算力、能接受双槽与更高功耗,选 A10;边缘部署、功耗与体积是第一约束,看 A2 一类低功耗卡。
四、整机与散热要求
T4 单卡 70W,但四卡同机时局部热流密度并不低,1U 服务器要靠前置高转速风扇直吹。被动散热卡必须保证风道,装在普通塔式机箱里容易过热降频。
配盘建议:模型文件与镜像放 NVMe,数据集与日志放企业级 SATA 或大容量企业盘;推理服务对随机读敏感,NVMe 做缓存层能明显降低首包延迟。
五、采购与验货
1. 核对是否为原厂单槽半高形态,市面有改装全高散热的卡,风道不匹配。
2. 上机用厂商工具读显存容量与型号,确认不是改标卡。
3. 跑一轮持续 30 分钟以上的推理压测,看是否降频、是否掉卡。
4. 确认驱动与推理框架版本兼容,图灵架构在新版软件栈里的支持范围逐年收窄。
5. 批量采购要求提供 S/N 清单与上机记录,便于后续核验。
六、常见问题
1. T4 还能跑现在的主流框架吗?
能,但要按实际版本核对。老架构在新版推理框架里可能不再有最优算子支持,部署前先做一轮实测比看文档更可靠。
2. 一张 T4 能支撑多少并发?
取决于模型规模、量化精度与输入长度,没有通用数字。建议先按目标并发做压测,再按结果决定卡数,别按参数表推算。
道通存储做希捷、西数企业级硬盘、三星与 Intel/Solidigm 企业级固态盘、NVIDIA 专业卡的国内渠道,出货可随箱提供序列号清单,也能按客户要求先跑一遍官方核验再发货。有选型、配盘、批量报价需求,可以直接联系我们。